


Infraestructura GPU Bare Metal para IA y aprendizaje automático
Servidores dedicados para inferencia de LLM, ajuste fino, pipelines RAG, agentes de IA y entrenamiento distribuido. Sin recursos compartidos y sin capa de virtualización.
Salida completa de GPU, en cada ejecución.
Diseñado para las cargas de trabajo que fallan en la nube compartida
GPU completa, sin contención
Bare metal dedicado significa que no hay inquilinos compitiendo en tu hardware. Rendimiento constante para cargas de trabajo de inferencia y entrenamiento a cualquier escala.
VRAM que se adapta a tu modelo
De 32 GB a 96 GB por GPU, hasta 768 GB en total en un solo servidor. Ejecuta modelos grandes sin límites de slot ni descarga de memoria.
Precios transparentes y predecibles
Sin cargos por egreso ni costos de infraestructura ocultos. Tarifas fijas por hora de GPU en plazos de 12 y 24 meses.
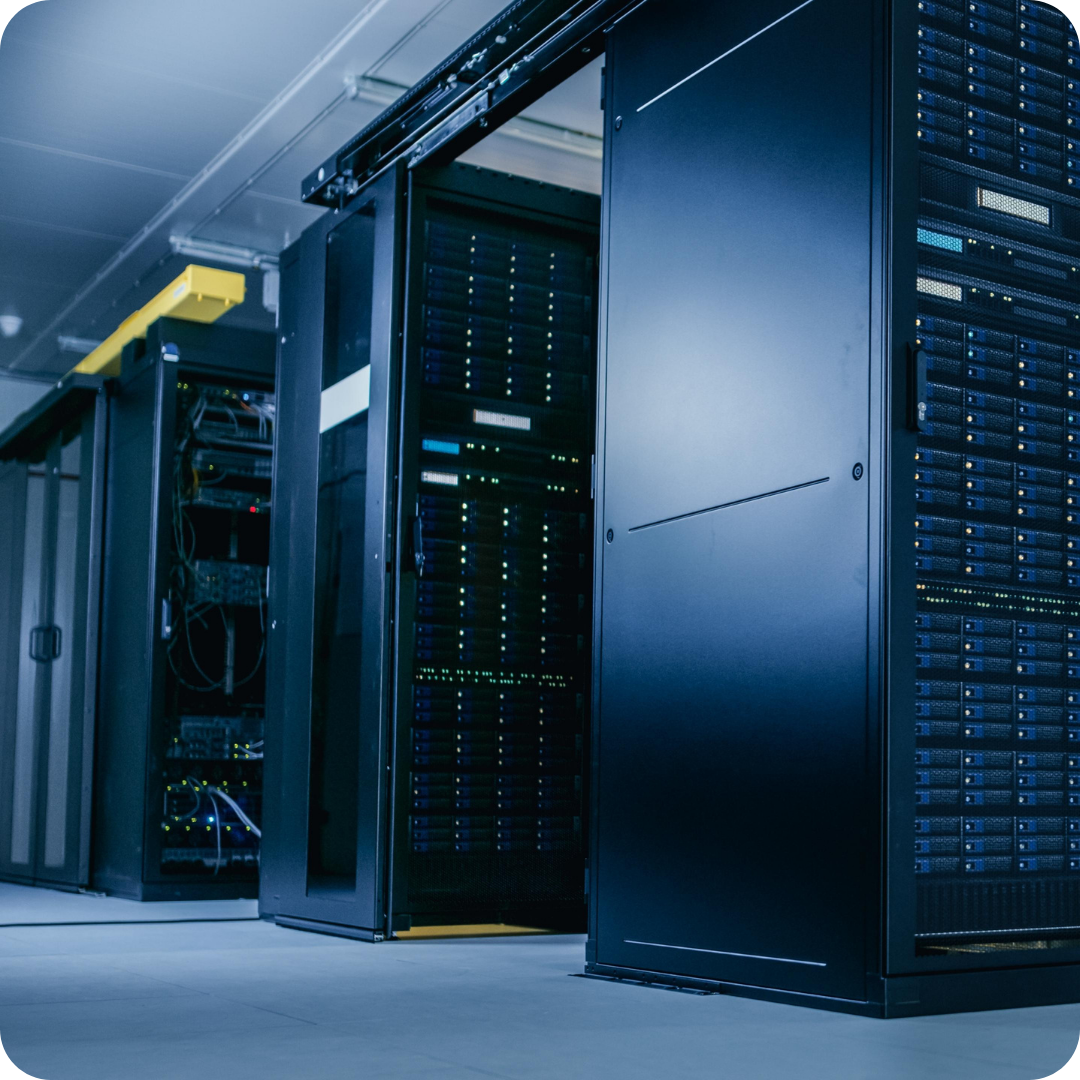
La capa de infraestructura de la que depende tu pila de IA
La mayoría de los problemas de infraestructura de IA no son problemas de modelo. Son problemas de infraestructura.La nube de GPU compartida introduce variaciones de latencia, restricciones de VRAM y degradación del rendimiento bajo carga, porque el hardware se comparte con inquilinos que no controlas.
1Legion bare metal elimina esa variable. Obtienes el servidor completo, hardware dedicado, acceso directo y un rendimiento constante desde la primera solicitud hasta la diezmilésima.
Ya sea que estés sirviendo inferencia de LLM a escala, ejecutando pipelines de ajuste fino, construyendo sistemas RAG o desplegando infraestructura de IA privada, el hardware funciona de la misma manera en todo momento.
¿Listo para ejecutar tu carga de trabajo de IA en un servidor bare metal dedicado?
Cuéntanos sobre tu pipeline. Nuestro equipo te asignará la configuración de servidor adecuada.
Solicitar Acceso al Servidor

